- 登入
- 註冊
一週 AI 大事・完整延伸閱讀
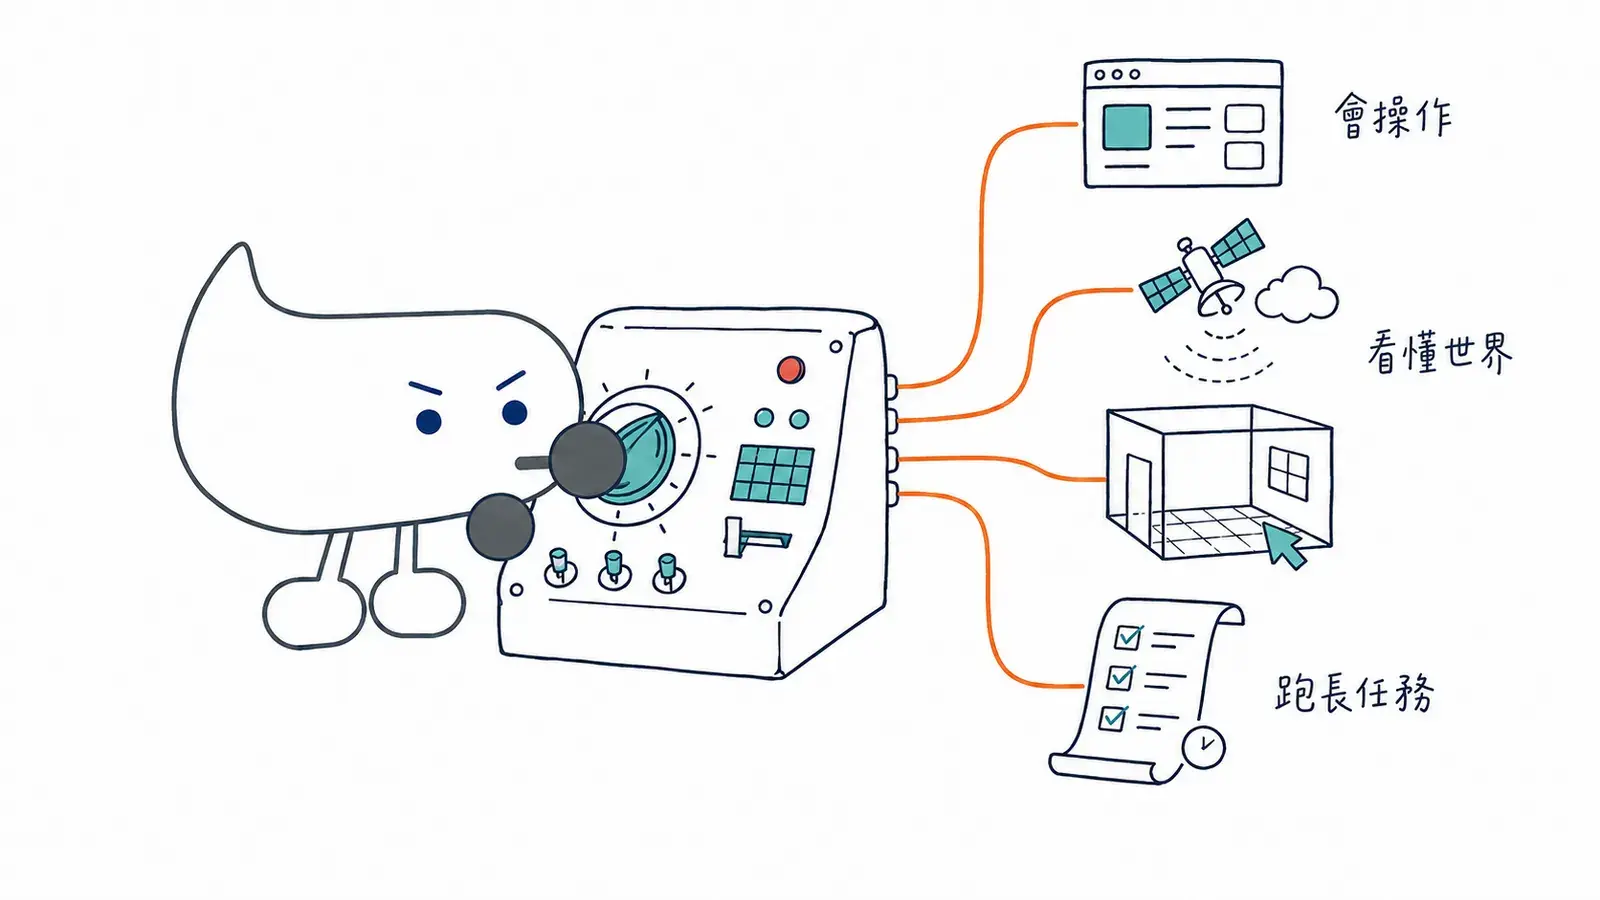
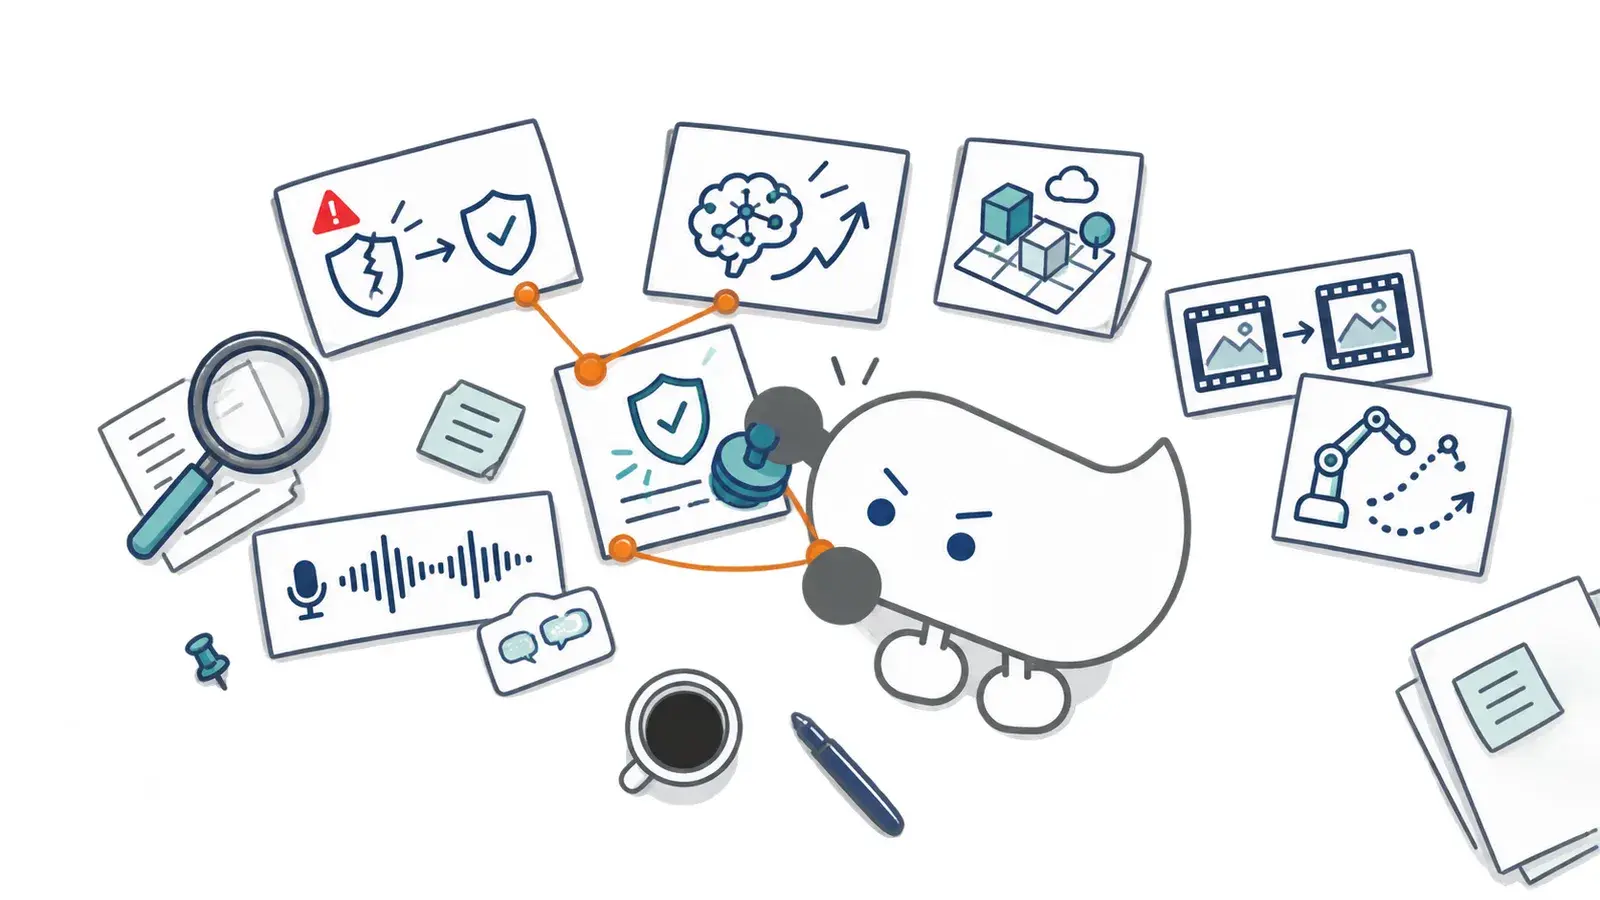
2026/09/21這週的主線不只是模型變快,而是 AI 正同時往三個方向前進:更快做選擇、持續改進搜尋策略,以及在影音、虛擬世界與機器人裡接手更長的動作流程。
本週完整整理
以下依 9/21 的橫式字幕稿整理,並重新核對研究團隊、產品頁、論文與正式專案。數字若來自廠商自評或小規模實驗,會放回它原本的測試條件,不把宣稱直接寫成普遍事實。
資安團隊 Hacktron 從 OpenAI 社群論壇的 HEIF 圖片解碼漏洞切入,再串接單一登入設定問題,成功接觸到 ChatGPT/Codex 員工帳號與內部程式庫權限。他們依漏洞懸賞流程回報,OpenAI 在獲報後修補,並於 9 月 1 日發放 6,500 美元獎金。
真正危險的往往不是單一漏洞,而是兩個看似分開的弱點被串成完整攻擊路徑。這次也顯示,AI 服務的圖片處理、社群系統與員工登入,都可能成為同一條供應鏈的一部分。
Diogo Almeida 團隊推出 Jev,定位為 System One 決策模型。它不是生成一大段文字,而是在預先定義的選項中快速選擇下一步;官方標示回應時間約 70~500 毫秒,可用於網頁操作、遊戲、分類與即時路由。
許多 Agent 任務真正需要的不是長篇推理,而是低延遲、結構固定的下一個動作。Jev 把輸出空間縮小後,更容易接進需要即時反應的系統。
Google DeepMind 團隊提出 Dream‑RSI:它把過去的探索紀錄整理成可精確重播的發現樹,先在不增加新執行成本的模擬器中測試大量搜尋策略,再把表現最好的策略帶回真實任務。
自我改進不一定要不斷燒更多算力。若模型能從既有探索歷史學會「下一次該怎麼找」,演算法、數學最佳化與 GPU 核心設計這類昂貴任務,就可能更有效率。
Google 在 9 月 15 日推出 Gemini 3.8 Live 與 Extended Thinking。新版可在對話持續進行時於背景執行 API 與工具,也支援即時視覺輸入,以及在對話中自動切換 97 種語言。
過去語音助理一查資料就停住,會讓互動像在等客服轉接。背景工具呼叫把「對話」與「工作」拆開並行,對即時客服、導覽與現場助理更實用。
阿里巴巴發布 Qwen3.8‑Omni‑Flash,可同時接收文字、圖片、音訊與影片,輸出文字,並支援最高 100 萬 Token 上下文、工具呼叫與多步 Agent 工作流。官方也特別強調空間音訊理解能力。
影音理解不必再拆成轉錄、抽幀、辨識與文字推理好幾段流程。對長影片檢索、會議、客服與多媒體 Agent 來說,輸入管線能變得更直接。
Qwen 同步推出 LiveTranslate 即時語音翻譯模型,可接收 60 種來源語言,並以 29 種語言輸出語音。官方報告平均延遲指標 LAAL 為 2.3 秒,低於前一版的 2.8 秒。
即時翻譯的體感關鍵不是只看字面準確率,而是能否在語句還沒說完時做出穩定預測。延遲縮短後,更接近會議、直播與跨語言對話需要的節奏。
XGEN Labs 公開 JING & DAO 世界模型架構。JING 負責生成觀察者看見的第一人稱世界;DAO 則維護共享世界狀態、規則與自主角色,讓使用者離開視角後,世界內的事件仍可繼續發展。
生成式 3D 正從「做出一段畫面」走向「維持一個有狀態的世界」。如果角色、規則與記憶能長時間一致,遊戲、模擬與數位分身的設計方式都會改變。
Runway 上線 Enhance Frame Rate,可在既有影格之間補出新畫面,輸出 25、30、48、60 或 120fps。官方說明支援最高 4K、最長 5 分鐘的來源影片,輸出會維持原始解析度。
AI 影片常見的跳動與低幀率,可以在後製階段變得更流暢;慢動作、運動畫面與高更新率播放也多了一個直接工具。
Viggle 發布 Meridian,一個幾何導引的 re‑camera 模型。它可根據原始影片與指定相機路徑合成新視角,也能暫停時間、拉出鏡頭路徑,製作類似子彈時間的效果。
傳統拍攝一旦結束,鏡位大多跟著固定。重新運鏡模型讓剪輯者能在後製階段重新設計觀察角度,對產品展示、動作片段與短影音轉場很有想像空間。
GPT‑Policy 提出一套機器人策略框架:固定的通用視覺語言模型先理解情境,再由 context compiler 整理示範與狀態,最後只能透過受限制的機器人工具執行。新示範可在測試時加入,不需要梯度更新或重新訓練模型。
機器人學新技能如果每次都要蒐集資料、重訓模型,成本很高。把示範直接變成當下可用的上下文,可能讓少量教學更快轉成新任務嘗試。
讀完最常問
不是。它的輸出被限制在預先定義的合法選項中,因此不會生成不存在的欄位;但在這些選項之間,仍可能選錯。高風險動作依然需要人工確認與驗證。
120fps 是補出更多時間影格;4K 是支援的來源解析度上限。它能讓動作更流暢,但不等於把缺失的空間細節全部還原。模糊、壓縮與生成瑕疵仍要另外處理。
兩者都會利用新的經驗改變後續行為,但方法不同。Dream‑RSI 在發現樹中評估並更新探索策略;GPT‑Policy 則把人類示範加入當下上下文,不需要重新訓練底層模型。它們都不是無限制自行成長的通用智慧。
易悅元宇宙社群免費開放。除了每週整理,也可以交流工具、內容創作與實際使用心得。