一週 AI 大事|2026/09/07:AI 開始真的操作、執行與建構世界

一週 AI 大事・完整延伸閱讀

2026/09/07

AI 不只會回答,開始真的操作、執行與建構世界

這週四大實驗室密集更新模型,焦點從「答得更聰明」轉向「能不能把長任務做完」。另一邊,AI 也開始直接讀衛星、控制鏡頭路徑,並把真實空間拆成可編輯的 3D 世界。

會操作電腦跑長任務看懂真實世界
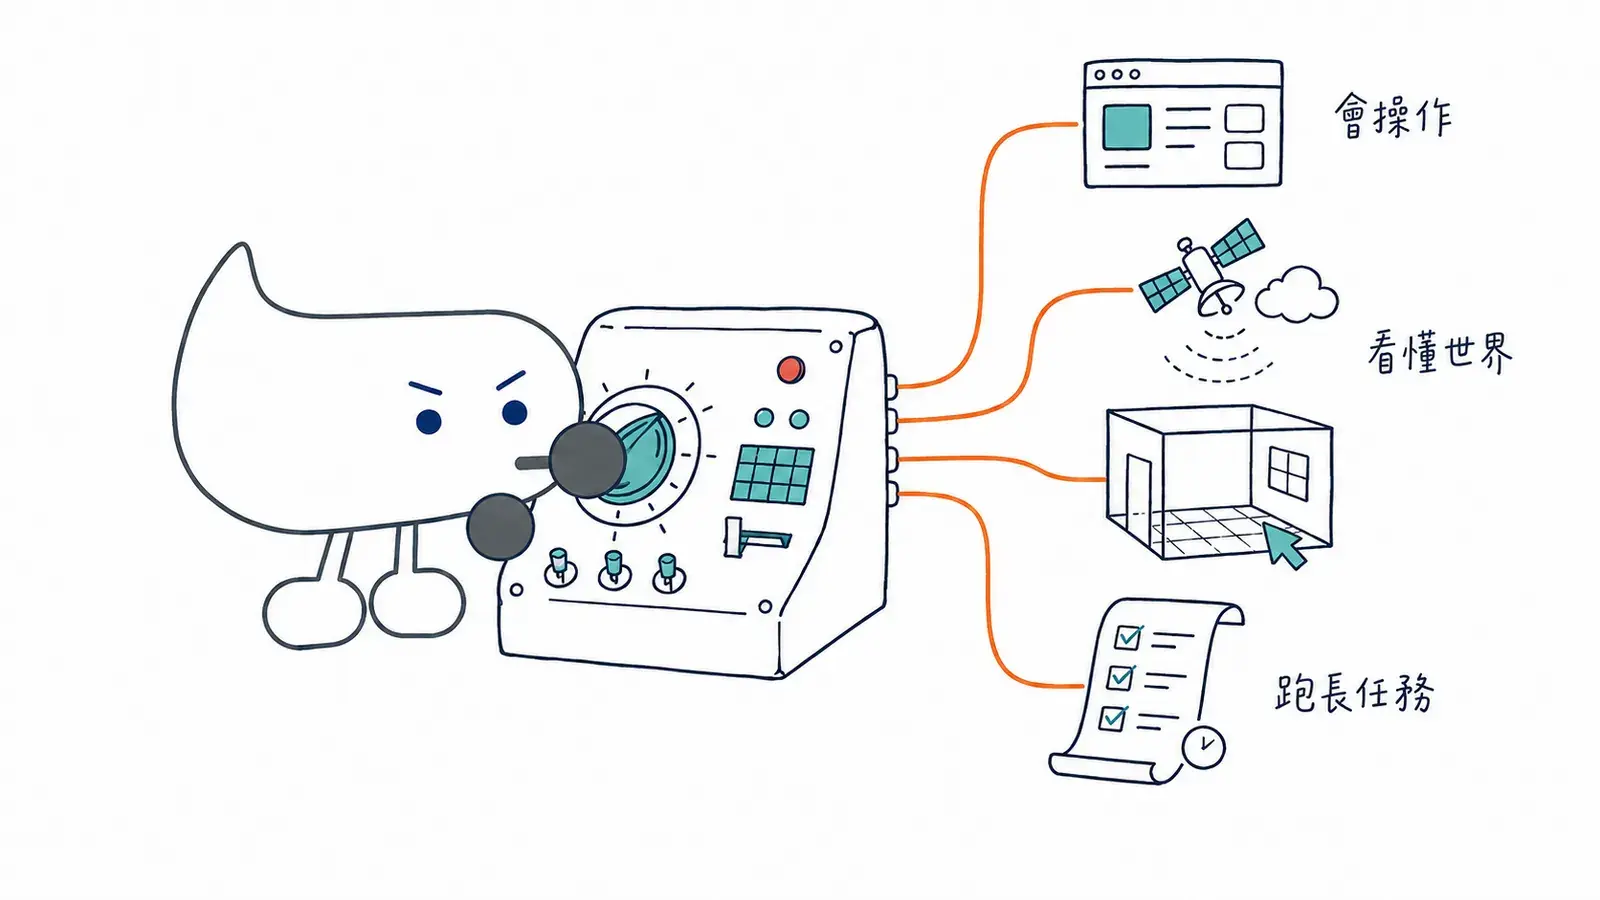
易悅吉祥物操作控制台,連接電腦操作、衛星天氣、三維世界與長任務

本週完整整理

8 則 AI 更新,一則一則看懂

以下依你提供的 9/7 整理內容製作,並以官方公告、模型頁、論文與專案頁重新核對。展示影片、廠商跑分和第三方速度測試會分開標示,避免把宣傳數字寫成普遍保證。
AI 操作電腦視窗的示意
01分階段上線

OpenAI GPT‑6 Astra:把電腦操作變成旗艦模型的核心能力

發生什麼

OpenAI 在 9 月 3 日發表 GPT‑6 Astra,主打電腦操作、瀏覽、程式、科學與專業工作。官方展示涵蓋試算表、PCB 佈線、CAD、Blender 接 Unreal Engine,以及從提示建立可玩的遊戲。

為什麼值得注意

這次進步不只是生成一份答案,而是能在多個工具裡持續操作、檢查結果並完成工作成品。對剪輯、設計、資料整理和軟體開發來說,模型與專業軟體之間的距離又縮短了一步。
展開展示、跑分與能力邊界
  • 官方 OSWorld 2.0 評估中,Astra 得分 72.6%,GPT‑5.6 Sol 為 65.7%;這是特定版本、特定代理環境下的結果。
  • OpenAI 公開頁面確實展示 Excel、CAD、Blender、Unreal Engine 與遊戲製作,但沒有足夠一手資料確認「Final Cut 自動完成完整調色剪輯」這個具體案例,因此本文不把它列為已驗證展示。
  • 「只要 Token 夠就沒有做不到」不是可查證的產品規格。實際能否完成,仍受權限、工具、環境、任務難度與安全確認限制。
長時間研究任務與時鐘的示意
02正式上線

Claude Fable 5.1:瞄準長時間程式與知識工作

發生什麼

Anthropic 在 9 月 1 日推出 Claude Fable 5.1,定位為目前最強的通用 Claude,著重程式、長週期代理、企業知識工作與研究能力,並已提供給付費方案與 API 使用者。

為什麼值得注意

Fable 5.1 的重點是能在數小時、跨多個應用的任務裡持續規劃、找出根因、修正失敗並保留進度。這代表頂尖模型的競爭,越來越像是在比誰能可靠地接下一整段工作。
展開價格與研究能力邊界
  • Fable 5.1 API 定價為每百萬輸入 Token 10 美元、輸出 50 美元;GPT‑5.6 Sol 為 4/20 美元。以單純 Token 單價比較是 2.5 倍,不是 3.7 倍。
  • 不同模型每項任務實際會用掉多少 Token、能否命中快取都不同,因此「每項任務成本」不能只靠單價倍數推算。
  • Anthropic 把科學研究能力描述為未來協助科學進展的早期跡象;這仍不等於模型已能獨立完成與驗證所有科研工作。
多條代理工作流匯整與自我修正的示意
03正式上線

Meta Muse Spark 1.3:同一個長對話裡管理多條工作流

發生什麼

Meta 在 9 月 2 日發布 Muse Spark 1.3,強化代理與程式任務。它能在同一個長對話中追蹤多條工作流,面對混亂或互相衝突的資料時補足情境、修正計畫,必要時向使用者確認。

為什麼值得注意

長任務失敗常不是因為模型不會寫,而是中途忘記限制、做錯仍宣稱完成,或無法判斷何時該停下來問人。Muse Spark 1.3 把這些協作與自我校準能力放進主要產品方向。
展開效率、評測與開放狀態
  • Meta 內部比較顯示,相較 Muse Spark 1.2,1.3 約少用 20% 工具呼叫與 25% Token;這是 Meta 自己的工程評估。
  • 它目前可在 Muse Code 與 Meta Model API 使用;官方只說未來會推出 Muse Spark 開放權重,1.3 本身不能先寫成已開源。
  • 官方方法文件混合自家測試、公開榜單與其他廠商自報數字,跨模型排名仍要看評測環境是否一致。
高速產生程式碼的示意
04全面提供

Gemini 3.8 Flash:用 Flash 價格挑戰長週期程式任務

發生什麼

Google 在 9 月 2 日推出 Gemini 3.8 Flash,提升軟體工程、代理與多步推理能力,並維持 3.7 Flash 的促銷價格。模型已進入 Gemini App、AI Studio、API、Antigravity 與 Google Sheets。

為什麼值得注意

Flash 系列原本主打速度與成本,現在也開始正面處理更長、更複雜的工程任務。這讓團隊不一定要把每個代理步驟都交給最昂貴的旗艦模型。
展開速度、排行與價格說明
  • Google 官方定價為每百萬輸入 Token 0.75 美元、輸出 3.75 美元,優惠至 2026 年底。
  • 「每秒 348 個 Token」不是 Google 的固定規格。Artificial Analysis 的即時頁面在本文查證時約為 398 Token/秒,數字會受服務商、推理等級與量測時間影響。
  • Google 公告寫的是在 DeepSWE 1.1 上超越多數更大型模型;「Deep Suite 第一名」屬第三方榜單快照,不能寫成穩定不變的官方排名。
模型能力持續升級的柱狀圖示意
05API 快照更新

Qwen3.8‑Max‑0902:集中補強程式、協作代理與視覺理解

發生什麼

阿里巴巴為 Qwen3.8‑Max 推出 0902 快照,針對工程規模的程式開發、長週期自主任務、多工具協作與文件圖表理解再做後訓練,同時保留 100 萬 Token 上下文與完整工具生態。

為什麼值得注意

這不是單純換型號,而是針對實際代理工作最常卡住的地方補強。發布時公開的比較表裡,多個程式與知識工作基準提升超過 10 個百分點,部分項目高於 Claude Opus 5。

展開數字、價格與開放狀態
  • 官方頁面確認模型 ID 為 qwen3.8-max-0902,支援文字、圖片與影片輸入,最大輸出 131K Token。
  • 「提升超過 10 個百分點」不是每個測試都成立;例如 DeepSWE 1.1 由 56.6 升至 69.3、JobBench 由 53.4 升至 64.0,而其他項目提升較小。
  • 0902 是 QwenCloud 的 API 快照,定價維持輸入 2 美元、輸出 6 美元/百萬 Token;不能和 8 月公開的權重版本混為一談。
衛星與雲層組成高解析天氣預報的示意
06已整合產品

WeatherNext 3:直接讀即時衛星資料,每小時重做全球預報

發生什麼

Google DeepMind 與 Google Research 推出 WeatherNext 3。模型直接吸收全球即時衛星觀測,每小時產生一次新預報,地表溫度與濕度最高可達 5 公里解析度,並已接入搜尋、Gemini、地圖與雲端服務。

為什麼值得注意

上一代主要是 25 公里網格、每 6 小時更新。更細、更快的全球預報,能更早看見快速形成的降雨、風場與局部溫濕度變化,也能支援農業、救災與再生能源調度。
展開五倍解析度與使用限制
  • 「五倍」是把 WeatherNext 2 的 25 公里網格,與 WeatherNext 3 最細的 5 公里地表變數相比;其他地表變數約 10 公里、大氣變數約 25 公里。
  • 更新頻率從 6 小時到 1 小時,指模型取得新衛星觀測並產生全球預報的週期。
  • Google 仍提醒,官方氣象預報、劇烈天氣警報與公共安全通知應以各地氣象機關為準。
在三維世界中設計相機路徑的示意
07早期存取

World Labs Atlas:把相機路徑變成世界模型的原生控制

發生什麼

World Labs 在 9 月 1 日公開 Atlas 世界模型。它能整合文字、圖片、影片、相機姿態與 3D 深度,在共同空間脈絡中生成新視角、重建場景,也能依手動設計的相機路徑生成最長 1 分鐘、1440p 影片。

為什麼值得注意

多數影片模型只能用文字粗略描述運鏡;Atlas 把相機位置與角度當成原生輸入。創作者更像在虛擬場景裡排鏡頭,而不是反覆抽生成結果。
展開輸入、輸出與開放狀態
  • 官方 1 分鐘 1440p 範例使用少量參考圖片與人工設計的相機路徑;不是只輸入一句文字就自動完成所有分鏡。
  • Atlas 也能輸出點雲與 3D Gaussian Splat,用於重建、遊戲、VFX 與機器人模擬。
  • 目前是選定合作夥伴的 early access,尚未像 Marble 一樣全面開放。
室內場景拆成可編輯三維物件的示意
08論文/專案

ByteDance Seed Lucida:把真實房間拆成可編輯的 3D 物件

發生什麼

ByteDance Seed 團隊提出 Lucida,先從多視角室內拍攝中辨識物件,再補全被遮擋的外觀、生成獨立 3D 資產,最後由 GizmoAct 反覆調整位置與角度,重建成可編輯的場景。

為什麼值得注意

傳統場景重建常得到一整塊難以拆動的模型;Lucida 讓桌椅、櫃子等物件保持獨立,能被搬動、替換或放進機器人模擬,離可操作的數位分身更近。

展開輸入方式與實驗結果
  • Lucida 的主要輸入是有相機姿態的多視角觀測/影片,不是只靠一張雜亂室內照片完成完整重建。
  • 每個物件會保留參考視角、遮罩、部分點雲與 3D 邊界框,再生成完整網格;最後由視覺語言模型操作 3D 編輯器對齊。
  • 論文報告在場景偵測、物件姿態與重建指標上優於多個基準方法;仍屬研究團隊自己的實驗結果。

讀完最常問

本週 FAQ

GPT‑6 Astra 現在真的可以自己完成任何電腦工作嗎?

不能這樣概括。它的電腦操作與專業軟體展示確實大幅進步,但是否能完成任務,仍取決於工具是否開放、權限、環境穩定性、任務難度與需要的人類確認。

這週四個新模型,哪一個一定最強?

沒有單一答案。Astra 強在電腦操作與高難度專業任務,Fable 5.1 瞄準長週期知識與程式工作,Muse Spark 1.3 強調協作與多工作流,Gemini 3.8 Flash 則把速度、成本與代理能力放在一起。最好用自己的真實工作測試。

Atlas 和 Lucida 都在做 3D,差別在哪裡?

Atlas 是能生成、重建與模擬世界的多模態世界模型,特別強調相機控制;Lucida 是研究型 real-to-sim 管線,重點是把真實室內場景拆成一個個可編輯、可重新擺放的 3D 物件。

想跟大家一起討論這些 AI 更新?

易悅元宇宙社群免費開放。除了每週整理,也可以交流工具、內容創作與實際使用心得。
加入元宇宙社群
Ad Feature

🚀 加入易悅元宇宙|節省時間創作基地

在這裡你可以認識更多的創作者、找尋自己的靈感、每週獲得創作心法,社群免費開放。歡迎你一起加入✨

分享此內容: