一週 AI 大事|2026/8/17:Grok 4.6、GPT‑5.6 Sol、Gemini 與本地 AI

一週 AI 大事・完整延伸閱讀

2026/08/17

AI 正在變得更快、更便宜,也更靠近個人裝置

這週從旗艦模型、手語輸入,到能在本地運行的開放權重模型,變化不只在跑分,而是 AI 開始更直接地進入工作、創作與真實世界。

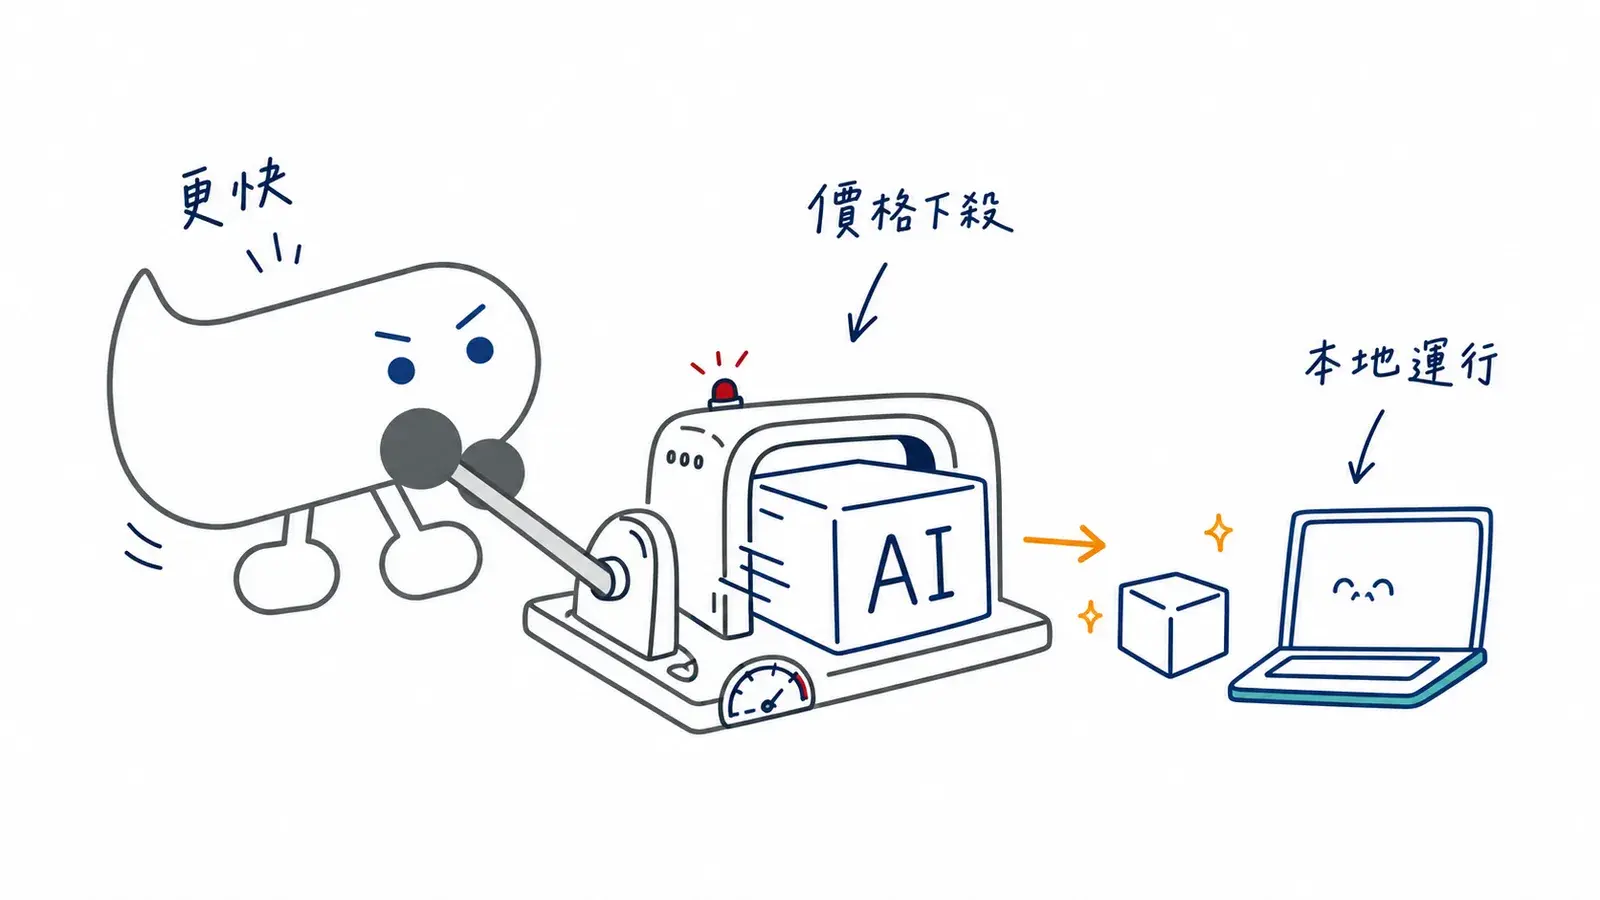
更快價格下殺本地運行
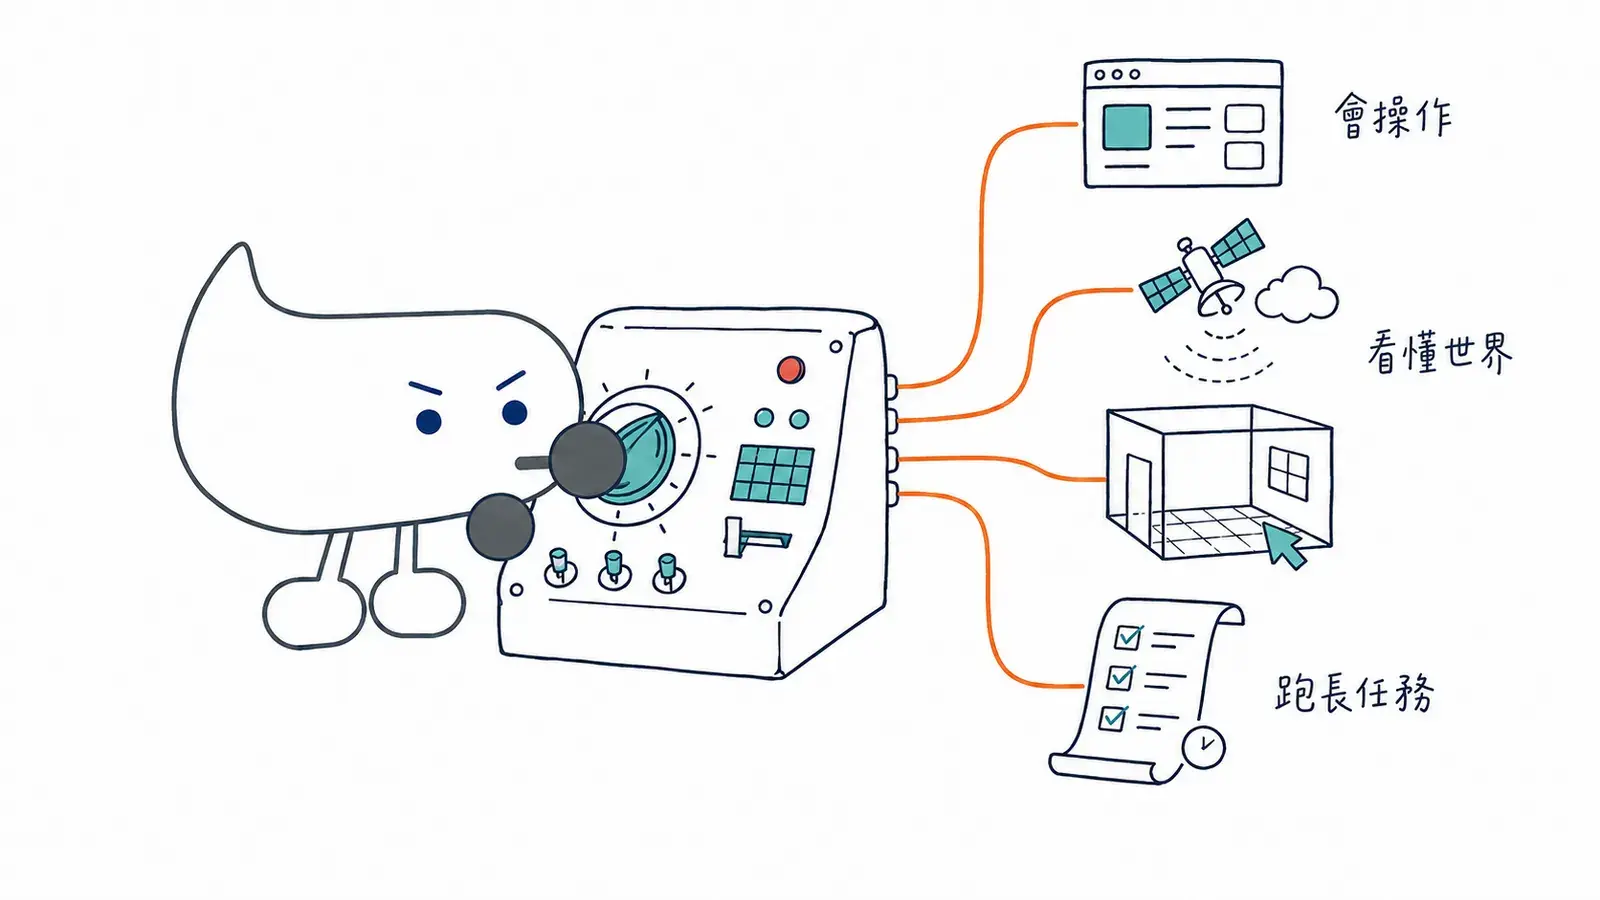
易悅吉祥物操作調速裝置,把大型 AI 模型縮成能在個人電腦運行的小模型

本週完整整理

8 則 AI 更新,一則一則看懂

IG 短影片先帶大家快速看完;這裡補上每則消息的背景、為什麼值得注意,以及可以繼續往下看的原始來源。
旗艦 AI 代理完成長任務示意
01已上線

Grok 4.6 打進旗艦模型第一線

發生什麼

xAI 在 8 月 12 日推出 Grok 4.6,主打長時間代理、程式開發、多步驟工作與互動式視覺成果。xAI 的發布文指出,它在當時的 Artificial Analysis Intelligence Index 與 GPT‑5.6 Sol 並列。

為什麼值得注意

它最值得看的不只是總分,而是長任務裡的自我檢查、工具使用和工作效率。這表示 Grok 已經不只是「追上」,而是開始和最前面的模型正面競爭。
展開跑分與查證補充
  • 「與 Sol 並列」來自 xAI 發布時引用的 Artificial Analysis 綜合指標快照,不代表兩個模型在每一項能力都相同。
  • 第三方排行榜會隨評測方法、新版本與新模型更新;本文不把當週分數寫成永久名次。
  • xAI 將互動式成果與長任務列為主要改進,但實際效果仍會受提示、工具與工作環境影響。
AI 極速模式與速度表示意
02限量預覽

GPT‑5.6 Sol 推出 Ultrafast 極速模式

發生什麼

OpenAI 在 8 月 13 日公布 GPT‑5.6 Sol Ultrafast。它由 Cerebras 提供運算,官方標示最高可比 Standard processing 快 14 倍,最高達每秒 750 個輸出 token。

為什麼值得注意

當旗艦模型能用接近即時的速度運作,金融研究、資安事件分析、客服、語音互動與電商決策,就不必再卡在長時間等待。
展開規格與查證補充
  • 「14 倍」與「750 tokens/秒」都是最高值,不代表每個提示、每個工作都固定達到。
  • 目前是 API 的 limited preview,只開放給部分客戶,還不是所有使用者都能直接選用。
  • 官方舉例是金融研究與資安分析,不是讓 AI 自行下單交易。
Flash 模型兼顧速度與價格示意
03已上線

Gemini 3.7 Flash:能力升級,價格先砍半

發生什麼

Google 推出 Gemini 3.7 Flash,定位是 coding 與 agents 的新一代 workhorse 模型。它加強第一次寫對程式、UI 指令遵循與複雜知識工作,Gemini Spark 也改用這個模型。

為什麼值得注意

官方提供到 2026 年底的優惠價:每百萬輸入 token 0.75 美元、輸出 3.75 美元。模型更強,暫時價格又只有標準定價的一半,讓大量代理工作更容易算得過來。
展開價格與查證補充
  • 0.75/3.75 美元是到 2026/12/31 的 introductory pricing。
  • 官方預告 2027/1/1 起回到每百萬輸入 1.50 美元、輸出 7.50 美元。
  • 「更快」會受平台、提示長度與工具呼叫影響,不宜把單一體感當固定規格。
手機辨識手語並轉成文字示意
04Pixel 11 首發

SL2T 把手語直接轉成手機文字

發生什麼

Google DeepMind 發表 sign-language-to-text 模型 SL2T,先在 Pixel 11 提供美國手語轉英文。使用者可以直接對鏡頭打手語,再輸入 Gboard 或顯示在 Live Transcribe。

為什麼值得注意

它不是研究室裡的展示,而是直接放進手機的無障礙功能。模型會同時理解手、身體與臉部動作,也針對拿著手機時的單手手語做了實際使用優化。
展開語言與隱私補充
  • 這次能確認的產品支援是先從 ASL→英文開始;Google 表示正在擴充更多手語與應用。
  • 官方說明是姿勢追蹤在裝置端進行,再由伺服器翻成文字。
  • 研究資料涵蓋範圍與手機目前已上線的語言數不能畫上等號,所以本文不把「50 多種」寫成現有支援規格。
AI 模型在個人電腦本地運行示意
05開放權重

Qwen3.8‑27B:旗艦能力開始走進個人電腦

發生什麼

Qwen 釋出 Apache 2.0 授權的 Qwen3.8‑27B。這是一個 27B 的視覺語言模型,主打程式開發、專業工作、研究與長時間代理任務,官方模型卡也直接提供本地部署與量化模型入口。

為什麼值得注意

27B 這個尺寸在量化後可以部署到合適的消費級硬體或部分筆電,讓高能力的視覺與程式模型不一定只能留在雲端;實際需求仍取決於量化方式、上下文長度與運行工具。
展開本地運行與跑分補充
  • 「可以本地跑」不代表原始 BF16 權重能直接塞進每一台筆電;實際上通常要使用 GGUF 等量化版本。
  • 能不能順利運行取決於量化精度、記憶體、上下文長度與軟體;本文不再把 16GB 當成通用最低規格。
  • 官方自評顯示 SWE‑bench Pro 61.7、LiveCodeBench v6 90.3;這些是官方模型卡上的特定評測,不等於所有實際任務表現。
語音音樂與環境音統一生成示意
06程式與權重已釋出

MiDashengLM‑Gen:一次生成語音、音樂與環境音

發生什麼

小米研究團隊公開 MiDashengLM‑Gen。過去語音、配樂和音效常要分開生成再混音,這個模型改成用同一套端到端框架,直接產生包含說話聲、音樂與環境音的完整聲音場景。

為什麼值得注意

對影片、遊戲與有聲內容創作者來說,真正麻煩的常常不是「做出一個聲音」,而是讓不同聲音在同一段裡聽起來合理。統一生成代表製作流程有機會再少好幾步。
展開論文數字與查證補充
  • 論文在 Seed‑TTS 英文測試中,把字錯率從既有統一模型的 12.15% 降到 2.79%;專用 TTS 系統對照為 1.24%。
  • 論文、程式、Hugging Face checkpoint 與展示頁都已公開。
  • 「情緒」主要透過聲音表現與場景描述呈現,不等於模型能客觀判讀或生成所有人類情緒。
本地生成完整歌曲示意
07開放權重

MiniMax Music 3:本地生成最長 5 分鐘完整歌曲

發生什麼

MiniMax 公開 Music 3 權重。輸入歌詞和音樂描述後,它能生成最長 5 分鐘、包含前奏、主歌、副歌、橋段和尾奏的完整歌曲,輸出為 32 kHz、16-bit 立體聲 WAV。

為什麼值得注意

它不只是雲端網站的新功能,而是能自己下載部署的模型。完整版可在 24GB 以下顯存運行,透過 CPU offload 與逐層串流,連 8GB 顯卡也能跑,只是速度會變慢。
展開硬體與查證補充
  • 官方寫的是 full precision 在 24GB 以下顯存可跑;CPU offload 約需 22GB。
  • 8GB 顯卡要使用逐層載入等低顯存做法,速度較慢。這不等於完整模型檔案只有 8GB。
  • 目前需要 CUDA,且只支援非串流生成;歌詞、節奏與樂器控制仍是生成指引,不保證每次完全照做。
機器人從人類影片學習動作示意
08官方發布

Dyna‑2:機器人開始從百萬小時人類影片學動作

發生什麼

Dyna Robotics 發表 Dyna‑2,利用超過 100 萬小時的第一人稱人類影片預訓練。模型先從人類怎麼和物品互動開始學,再把能力轉到摺衣、取放與食物處理等真實機器人操作任務。

為什麼值得注意

機器人資料一直很難大量收集;如果能先看人類影片建立物理與動作常識,就不必每個技能都靠機器人一小時一小時重新示範,訓練規模才有機會像軟體一樣放大。

展開數據與查證補充
  • 官方說明是「超過 100 萬小時的 egocentric video」,也就是第一人稱人類行動影片。
  • 技術頁展示不同資料規模與後訓練任務的提升,但這些結果來自 Dyna 自己的測試,本文不把它寫成第三方驗證。
  • 從影片學到動作常識,不等於機器人已能在每個家庭無條件完成所有家務。

想跟大家一起討論這些 AI 更新?

易悅元宇宙社群免費開放。除了每週整理,也可以交流工具、內容創作與實際使用心得。
加入元宇宙社群

重點整理

Qwen3.8‑27B 真的能在一般電腦上運行嗎?

可以,但通常需要量化版本,也要看電腦的記憶體或顯存。原始 BF16 權重不是每台筆電都能直接載入;16GB 等級裝置可選擇合適的 GGUF 量化版本。

GPT‑5.6 Sol 的 14 倍速度現在每個人都能用嗎?

還不行。Ultrafast 目前是 API 限量預覽,而且 14 倍與每秒 750 個輸出 token 都是最高值,實際速度會依任務和服務狀態不同。

開源與開放權重是一樣的嗎?

不完全一樣。開放權重代表模型檔案能下載,但能否商用、修改與再散布仍要看授權條款;文章會把模型頁與授權一起附上。
Ad Feature

🚀 加入易悅元宇宙|節省時間創作基地

在這裡你可以認識更多的創作者、找尋自己的靈感、每週獲得創作心法,社群免費開放。歡迎你一起加入✨

分享此內容: